Людина була в контурі. Перевірки — ні.
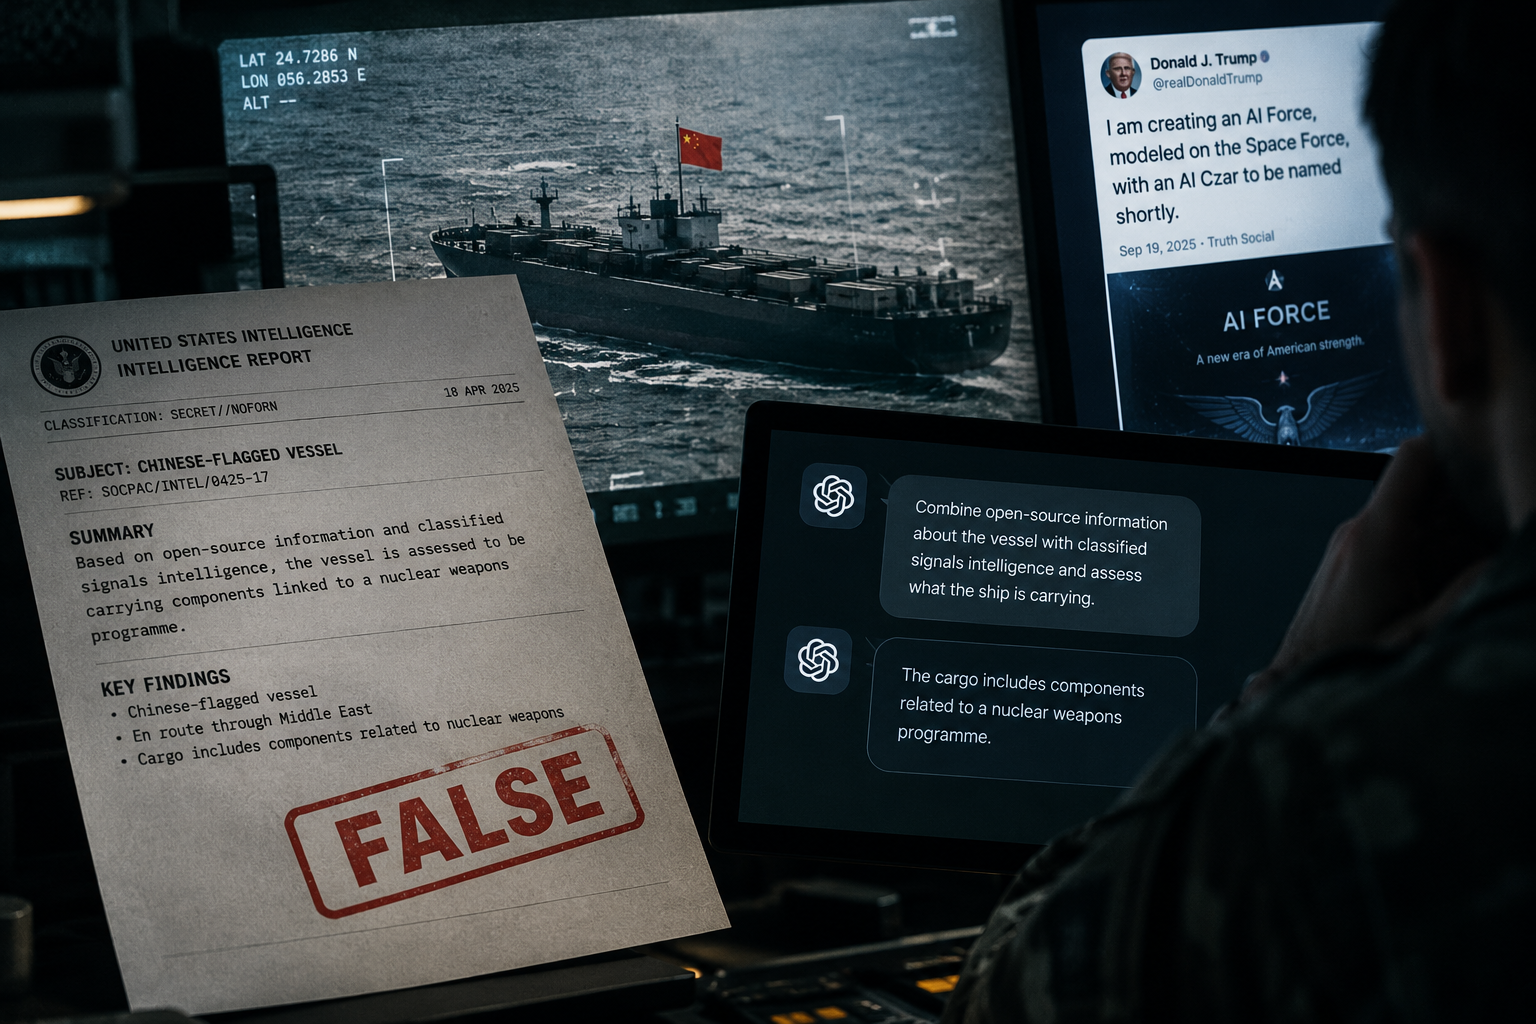
Звіт розвідки, підготовлений за допомогою чатбота, ледь не відправив американську абордажну групу на китайське судно.
Наступного дня президент оголосив про створення «AI Force».
На перший погляд ці дві події легко пов'язати. Але найцікавіше тут не те, що модель помилилася.
Проблема в іншому: військова розвідка вже не змогла чітко відрізнити оцінку, яку підготував аналітик, від тексту, який модель згенерувала і просто оформила як готовий розвідувальний документ.
Що сталося — і що ми насправді знаємо
18 вересня CNN повідомив, що під час весняної війни з Іраном американські сили були за кілька годин від перехоплення китайського судна на Близькому Сході.
У розвідувальній оцінці йшлося про те, що судно перевозить компоненти, пов'язані з ядерною зброєю.
Літаки вже були в повітрі. Озброєна абордажна група готувалася до операції. Її зупинили, коли чиновники повторно перевірили звіт і з'ясували, що для його підготовки використовували чатбот.
Чатбот неправильно визначив вантаж. Один зі співрозмовників CNN назвав цю оцінку «повністю хибною».
Наступного дня, 19 вересня, президент Трамп оголосив у Truth Social про створення «AI Force» за моделлю Космічних сил США. Також він повідомив, що незабаром буде призначений «AI Czar». Reuters зазначив, що в оголошенні не було деталей про структуру, підпорядкування, чисельність або повноваження нового органу.
Ці дві історії швидко почали подавати як суперечність: військові інституціоналізують AI одразу після того, як AI ледь не спричинив війну. Але це не зовсім правильний спосіб дивитися на ситуацію.
Сам інцидент стався за кілька місяців до оголошення. Просто стало відомо про нього лише напередодні.
Цікавіший зв'язок тут інший. Військові оголосили про нову організаційну структуру, але публічно не відповіли на питання, яке насправді ставить цей інцидент:
Хто відповідає за перевірку того, що говорить AI, і з чим саме це потрібно перевіряти?
Що відомо, а що ні
Усе, що зараз публічно відомо про цей випадок, походить з одного матеріалу CNN, який посилається на чотирьох неназваних джерел.
Пентагон і Special Operations Command Pacific не коментували ситуацію. Тому доказова база тут обмежена, і це треба пам'ятати, коли ми говоримо про деталі.
За інформацією джерел CNN, аналітик SOCPAC на Гаваях працював із розвідувальною інформацією про маніфест судна. Він попросив чатбот поєднати відкриті дані про судно із секретними даними радіотехнічної розвідки та оцінити, що саме перевозить судно. Модель зробила висновок, що серед вантажу є компоненти, пов'язані з ядерною зброєю. Потім аналітик використав чатбот вдруге — уже для того, щоб перетворити цей висновок на стандартний розвідувальний звіт. Документ пройшов військовими каналами і потрапив до людей, які планували операцію.
CNN не зміг встановити, яким насправді був вантаж, чи був це комерційний чатбот, чи державний інструмент, а також на якому саме етапі перевірки помилку виявили.
Одне з джерел заявило, що в американській системі немає єдиного набору правил для перевірки результатів таких інструментів. Інше сказало, що подібна галюцинація не була одиничним випадком.
Навіть із цієї обмеженої інформації можна досить впевнено сказати дві речі. По-перше, ніхто ні на кого не напав. Помилку все-таки виявили — до того, як відбулася висадка. По-друге, ця помилка пройшла досить далеко, перш ніж її помітили. І пройшла вона всередині документа, який виглядав так само, як інші розвідувальні документи, яким отримувачі звикли довіряти.
Два запити — і чому другий важливіший
Зазвичай цей випадок описують як «галюцинацію». У вузькому сенсі це правильно. Модель видала конкретне і впевнене твердження про вантаж, яке виявилося неправдою.
Але мовні моделі можуть впевнено вигадувати факти щонайменше з 2022 року. Будь-хто, хто у 2026 році вбудовує таку систему в розвідувальний процес, уже знає про цей ризик. Тому дивитися на саму галюцинацію як на головну проблему — це приблизно те саме, що звинувачувати датчик у тому, що він має відомий рівень шуму.
Цікавіша помилка сталася під час другого запиту. Розвідувальні документи отримують значну частину своєї довіри саме завдяки формі. Стандартний звіт із правильним грифом, оформлений за встановленим шаблоном, переданий правильним каналом і підготовлений аналітиком із відповідним доступом, викликає довіру не лише через зміст.
Сам формат передбачає, що до цього вже відбувся певний процес. Дані перевірили. Аналітик зробив висновок. Хтось переглянув документ. Той, хто отримує такий звіт, зазвичай не повторює всю цю роботу сам. Формат уже сигналізує: це хтось перевірив.
У цьому випадку саме формат став проблемою. Аналітик попросив модель оформити її власний висновок у вигляді стандартного розвідувального документа. Модель змогла відтворити зовнішній вигляд перевіреного звіту, не відтворюючи сам процес перевірки, який цей формат мав би підтверджувати.
Документ, який отримали планувальники, виглядав перевіреним. Але сам висновок ніхто незалежно не перевірив. Людина була присутня на кожному етапі. Людина ставила запити і передавала результат далі. Але сама процедура не відрізняла це від звичайної аналітичної роботи.
Ось у чому справжня проблема. Не в тому, що модель може помилитися. А в тому, що сигнали довіри всередині організації були створені під роботу людей. А добре написана машина може пройти через них майже без перешкод.
Раніше походження документа було непоганим орієнтиром для оцінки його якості. Тепер цього вже недостатньо. Треба знати не лише, хто підписав документ, а й які саме його частини написала модель.
Впевненість — це не правильність
Саме тому цю проблему треба вирішувати на рівні процедури, а не залишати на розсуд окремого аналітика. Мовна модель не «вірить», що на судні лежить певний вантаж. Вона генерує текст на основі закономірностей, які вивчила під час навчання, і матеріалу, який їй надали.
Коли даних недостатньо, вони суперечливі або неоднозначні, модель не обов'язково стає обережнішою. Вона все одно може видати дуже впевнену відповідь — таку, якою міг би виглядати правдоподібний розвідувальний звіт. Мова залишається впевненою, незважаючи на достовірність.
І сама модель не має внутрішнього сигналу, який сказав би читачеві, у якій із цих двох ситуацій він зараз перебуває. Звична аналогія — навігатор, який дуже впевнено веде водія прямо в річку.
Вона працює з однієї важливої причини: система може звучати впевнено навіть тоді, коли її оцінка неправильна. Але водій побачить проблему майже одразу.
Споживач розвідувальної інформації може зрозуміти її лише після завершення операції. У цьому і є головна різниця. І саме тому недостатньо просто сказати людям: «Будьте обережні з AI».
Що оператори давно знають про брехливі датчики
Будь-хто, хто літав на FPV в умовах роботи РЕБ, уже стикався з подібною проблемою — просто зазвичай не називав її саме так. Відео — це джерело інформації. Телеметрія — теж. Тепловізійна картинка — теж.
Усі ці системи можуть деградувати так, що ти не відразу зрозумієш, що вони вже брешуть. Наприклад, рівень якості каналу ще виглядає нормальним, а відео вже відстає від реальності на секунду. Теплова пляма може бути машиною. А може бути макетом. А може бути просто шматком теплого металу в полі.
GNSS може показувати плавну і дуже точну позицію — і при цьому брехати. Робоче правило тут не «не довіряй приладам». Воно простіше: якщо два джерела суперечать одне одному, не обирай те, яке виглядає впевненіше. Спочатку з'ясуй, яке з них бреше. Коли другого джерела немає, треба виходити з того, що єдине джерело може помилятися, і діяти обережніше.
Той самий принцип працює під час розробки каналів зв'язку й тепловізійних систем. Показник, який видає система, — не те, чому треба довіряти в першу чергу. Спочатку його треба зіставити з чимось, що ця система сама не створила.
У кабіні це працює тому, що наслідки помилки настають одразу й ти сам за них платиш. І друге джерело зазвичай доступне за кілька секунд.
У ситуації на Гаваях не було ні того, ні іншого. Аналітик мав одну систему, яка генерувала і сам аналіз, і документ.
Ціну помилки мав заплатити хтось інший. А процедура не вимагала порівнювати результат із незалежним джерелом.
Противник теж має право голосу
Є ще одна проблема, про яку говорять значно менше. Це проблема противника.
Аналітик поєднав відкриті дані з даними радіотехнічної розвідки. А відкриті дані за визначенням можуть бути змінені самим противником.
Під час тієї ж війни з Іраном за добу після удару в Бахрейні почали поширюватися згенеровані AI зображення нібито пошкодженої штаб-квартири П'ятого флоту. А один із широко використовуваних чатботів викрили на тому, що він підтверджував сфабриковані відео як справжні.
Тут виникає вже інша загроза. Якщо поєднання OSINT і SIGINT за допомогою чатботів стане звичайною практикою, противнику вже не обов'язково працювати лише з громадською думкою.
Він може бити прямо по розвідувальному циклу. Достатньо запустити у відкриті джерела правдоподібну брехню. Модель змішає її зі справжніми секретними даними.
А на виході можна отримати дуже переконливий звіт, у якому справжня інформація дає документу авторитет, а отруєний відкритий матеріал — неправильний зміст. Ніщо в матеріалі CNN не вказує на те, що саме це сталося тут. Але механізм, який випадково створив хибний висновок, цілком може бути використаний противником навмисно.
І захист від обох сценаріїв однаковий: результат роботи моделі треба вважати неперевіреним джерелом, незалежно від того, наскільки добре він оформлений.
Чого не пояснює «AI Force»
Що б у результаті не стало «AI Force», з публічних даних поки зрозуміло небагато.
Йдеться про організацію та управління: Хто відповідає за програми? Хто встановлює стандарти? Хто кому підпорядковується?
Стратегія Пентагону щодо прискорення AI від січня 2026 року і платформа GenAI.mil, якою, за словами самого відомства, вже користувалися понад 1,3 мільйона військових і співробітників, відповідають на інше питання: як дати людям доступ до таких інструментів і як швидко масштабувати їх використання.
Але жодне з цього не відповідає на питання, яке поставив інцидент із SOCPAC. Воно набагато прозаїчніше. Що відбувається, коли модель бере участь у створенні документа, який може запустити військову операцію? Хто зобов'язаний його перевірити? З чим саме? Хто має право зупинити документ? І як записується внесок моделі, щоб той, хто перевіряє звіт, розумів, що саме потрібно перевірити?
Новий орган може встановити такі правила. Але сама поява нового органу їх автоматично не створює. І якщо побудувати структуру без них, вона може просто масштабувати ту саму проблему.
Сумніватися в машині має бути чиєюсь роботою
Після цієї історії багато хто писав, що майбутнє — це не AI замість аналітика, а людина, навчена сумніватися в AI. Загалом це правильна думка.
Але як лозунг вона перекладає занадто багато відповідальності на одну людину. Цей випадок якраз показує, чому цього недостатньо. Можливо, сам аналітик сумнівався. Але люди, які отримали звіт, не мали жодного способу зрозуміти, що вони теж повинні поставити його під сумнів.
Тому сумнів має бути не особистою чеснотою, а частиною самої процедури. І за нього хтось має відповідати.
Я бачу тут три речі.
1. Позначати AI на рівні змісту
Якщо в документі є текст, згенерований моделлю, це має бути видно. Причому має бути видно, які саме частини створила модель. Тоді адресат може застосувати до них інший рівень перевірки. Так, це робить процес менш зручним. Але саме зручність і була однією з причин, чому ці інструменти взагалі почали використовувати.
2. Дати окремій людині право зупинити документ
Має бути людина, яка перевіряє документ до того, як на його основі починається операція. Це не повинна бути та сама людина, яка створила матеріал. І її роботу треба оцінювати не за кількістю швидко пропущених документів, а за кількістю помилок, які вона виявила. Це коштує часу. Але швидкість — саме одна з головних причин, чому AI зараз активно впроваджують.
3. Зберігати історію взаємодії з моделлю
Організація має зберігати, що саме запитували у моделі і що саме вона відповіла. Тоді, якщо звіт пізніше поставлять під сумнів, можна буде відновити весь процес його підготовки, а не сперечатися про те, що сталося. Це теж коштує грошей. Потрібне зберігання даних. Виникають питання класифікації та безпеки. Аналітик отримує більше контролю — і водночас більше відповідальності.
Усі три витрати реальні. Чи стане «перевірка машини» окремою функцією, залежить від того, чи готова організація за це платити.
Поки що стимули часто працюють у протилежний бік. Стратегічні документи говорять про прискорення. Платформи стимулюють масштаб.
А ситуацію, коли все закінчилося без пострілів, дуже легко записати в успіх системи, а не в доказ того, наскільки близько вона була до помилки.
Що має значення
Цей випадок із SOCPAC не доводить, що мовні моделі занадто ненадійні для роботи розвідки.
Він показує дещо неприємніше: вони можуть бути достатньо надійними, щоб їм почали довіряти за замовчуванням. Систему, яка очевидно помиляється, перевірятимуть. Систему, яка пише гладко, впевнено і в більшості випадків правильно, перевірятимуть дедалі менше.
До одного випадку, коли це справді матиме значення. Для інженерів, які створюють такі системи, мета не лише в тому, щоб модель менше галюцинувала.
Результат має бути неможливо сплутати з перевіреним розвідувальним документом — за структурою, візуально і на рівні метаданих. Для штабних офіцерів корисніше питати не тільки: «Це правильно?»
А: «Що саме в цьому документі перевірено за джерелом, якого модель сама не створювала?» І для тих, хто стежить за появою «AI Force», важливо дивитися не стільки на її організаційну схему.
Важливіше інше: чи опублікує нова структура стандарт перевірки і чи матиме хтось реальне право сказати «ні».
Правило оператора старше за будь-яку AI-технологію. Не працюй, спираючись на одне джерело. І не довіряй джерелу лише тому, що воно звучить упевнено.
Для штабів такого правила поки немає. Поки його не буде, людина в контурі залишатиметься формальністю. А сам контур зможе замкнутися без неї.
Finland can shelter a million people from a strike
What a Russian channel gets right, and leaves out, about the drones hitting Moscow